Строковые задачи на ЕГЭ по информатике: алгоритмы, Python-код и разбор ошибок
5

** изображение создано или обработано с помощью ИИ.
Строковые задачи на ЕГЭ по информатике требуют прежде всего точного понимания условия. Необходимо определить, какие символы рассматриваются, что считается подходящим фрагментом и какие действия выполняет алгоритм. Ошибки часто возникают не из-за сложности кода, а из-за неверной интерпретации формулировки.
Строка представляет собой последовательность символов: букв, цифр, пробелов и знаков. Порядок элементов имеет значение: строки ABBA и BABA содержат одинаковые буквы, но отличаются расположением символов.
Для решения школьных задач удобно использовать Python. Он позволяет обращаться к отдельным символам, искать подстроки, считать вхождения и выполнять замены. Однако правильный алгоритм начинается с анализа условия: понятия «подряд» и «в любом порядке» задают разные требования.
Основные термины строковых задач
** изображение создано или обработано с помощью ИИ.
— Символ — один элемент строки, например A.
— Подстрока — непрерывный фрагмент строки, например BB внутри ABBA.
— Подпоследовательность — символы, сохраняющие исходный порядок, но не обязательно расположенные рядом.
— Длина строки — количество символов, а не числовое значение записи.
Например, строка «2026» содержит четыре символа. Число 2026 представляет собой числовое значение. В Python кавычки обозначают строковый литерал и помогают отличать текст от числа.
Основные операции со строками в Python
** изображение создано или обработано с помощью ИИ.
Пусть переменная s содержит строку «ABAC». Выражение `len(s)` возвращает 4. Обращение `s[0]` даёт «A», а `s[3]` — «C». Индексация начинается с нуля, поэтому индекс последнего символа равен длине строки минус один.
Последний символ непустой строки можно получить с помощью `s[-1]`. Если строка может быть пустой, перед обращением к последнему символу необходима проверка.
Запись Python | Назначение | Результат для «ABAC» |
|---|---|---|
`s[1:3]` | Выбирает символы с индексами 1 и 2 | «BA» |
`»BA» in s` | Проверяет наличие подстроки | False |
`s.find(«AC»)` | Возвращает индекс первого вхождения | 2 |
`s.count(«A»)` | Считает неперекрывающиеся вхождения | 2 |
`s.replace(«A», «X», 1)` | Заменяет первое вхождение | «XBAC» |
У среза правая граница не включается в результат. Поэтому выражение `s[1:3]` возвращает два символа — «BA», а не три. Если `find()` не находит искомую подстроку, результатом становится -1. Это означает отсутствие вхождения, а не позицию символа.
Строки в Python неизменяемы. Метод `replace()` возвращает новую строку, не изменяя исходную. Чтобы сохранить результат замены, требуется присваивание:
«`python
s = s.replace(«A», «X», 1)
«`
Без присваивания исходная переменная s сохранит прежнее значение. Это особенно важно при последовательном выполнении команд, в которых результат предыдущей операции используется дальше.
Алгоритм поиска самого длинного подходящего фрагмента
** изображение создано или обработано с помощью ИИ.
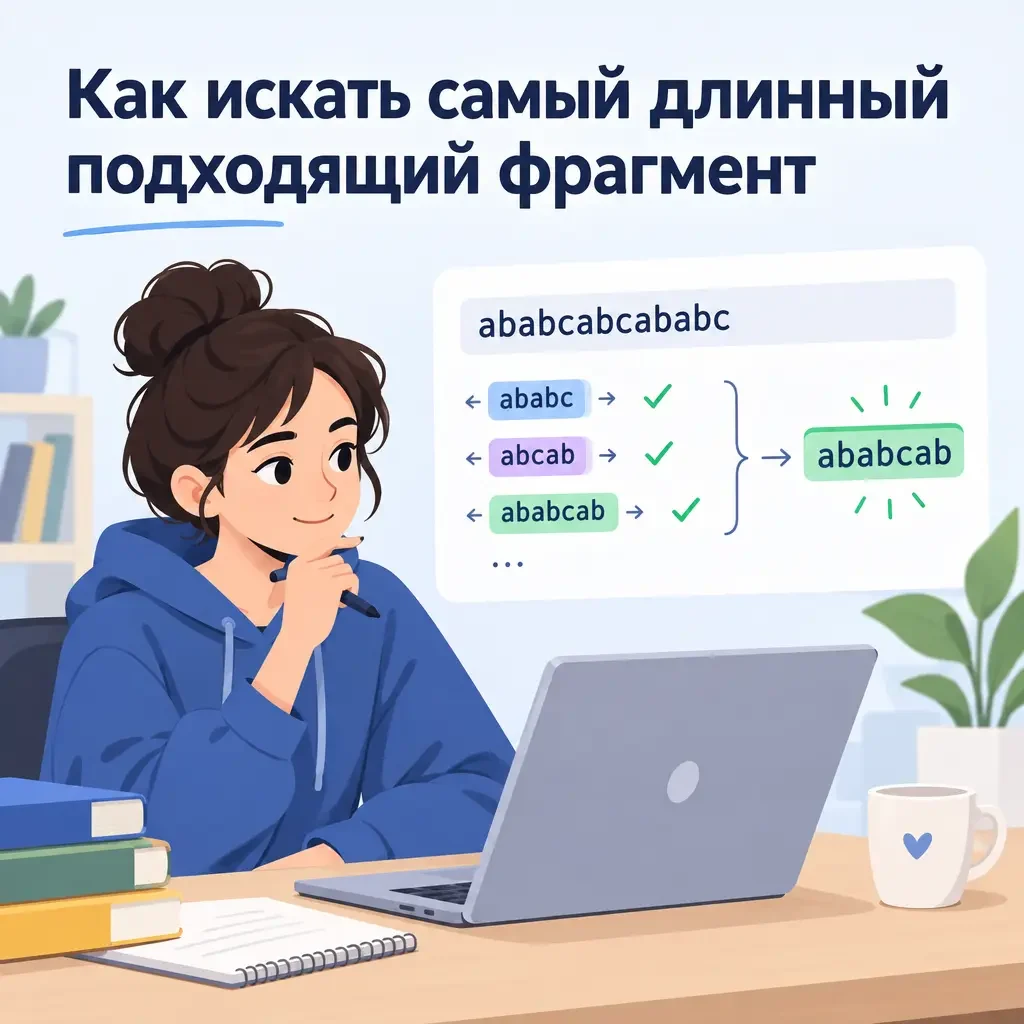
Один из распространённых типов заданий — поиск максимальной длины фрагмента, удовлетворяющего определённому условию. Например, требуется найти самую длинную последовательность, состоящую только из символов A и B, в строке, которая может содержать и другие знаки.
Для такого условия подходит алгоритм с двумя переменными:
- current хранит длину подходящего фрагмента, заканчивающегося текущим символом;
- best хранит максимальную длину среди уже обработанных фрагментов.
Оба значения первоначально равны нулю. Если очередной символ разрешён, значение current увеличивается на единицу. Если символ не подходит, current сбрасывается в ноль. После каждого шага обновляется максимум:
«`python
best = max(best, current)
«`
Рассмотрим строку «ABBAСABA», где кириллическая буква С обозначает запрещённый символ. До неё длина подходящего фрагмента достигает четырёх. После неё счётчик обнуляется, а затем увеличивается до трёх. Максимальная длина равна 4.
Важные нюансы алгоритма
Обновление максимума на каждом шаге позволяет учесть фрагмент, заканчивающийся последним символом строки. Если проверять максимум только после нарушения условия, последний фрагмент может остаться необработанным.
При этом похожие формулировки могут требовать разных алгоритмов. Например, условие «соседние символы различны» допускает последовательности с чередованием символов. Для строки «ABBA» максимальная длина такого фрагмента равна двум: подходят «AB» и «BA».
В этом случае текущая длина для непустой строки начинается с единицы. Каждый новый символ сравнивается с предыдущим. Если символы различаются, длина увеличивается. Если совпадают, начинается новый фрагмент длиной один.
Ключевой принцип — определить правило продолжения фрагмента. Пока условие выполняется, счётчик увеличивается. При нарушении условия выбирается правильная новая длина. Она не всегда равна нулю: для условия о различии соседних символов новый фрагмент начинается с текущего символа и имеет длину один.
Метод скользящего окна
Другой тип задачи — поиск максимального фрагмента, содержащего не более двух букв C. Здесь удобно использовать метод скользящего окна. Правая граница постепенно перемещается вперёд.
Если количество букв C превышает допустимое, левая граница сдвигается до восстановления условия. Так поддерживается максимально длинный допустимый фрагмент для текущей правой границы.
Строковый исполнитель: порядок замен
** изображение создано или обработано с помощью ИИ.
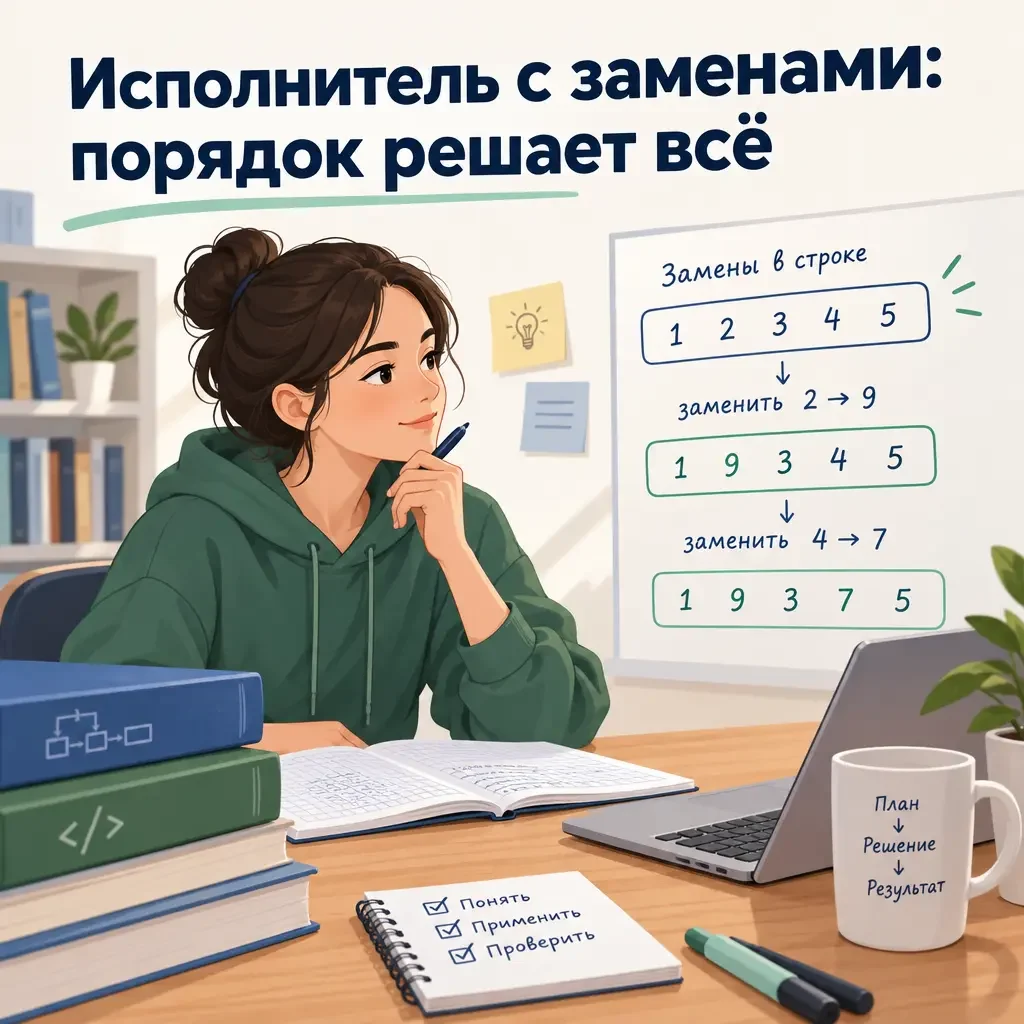
В задачах с исполнителем строка изменяется по заданным правилам. Одна из типичных команд заменяет первое вхождение указанного фрагмента. В Python для этого подходит метод `replace()` с третьим аргументом:
«`python
s = s.replace(«111», «2», 1)
«`
Последний аргумент ограничивает количество замен одной операцией. Без него Python заменит все неперекрывающиеся вхождения. Это уже другой алгоритм, поэтому число замен необходимо проверять по условию.
Рассмотрим строку «11111». Одна замена первого вхождения «111» на «2» даст «211». Результат «112» соответствовал бы замене правого вхождения, а не первого слева.
Структура ветвлений и проверок
Важна и структура ветвлений. Два отдельных оператора `if` могут последовательно проверить два условия и выполнить обе команды, если они истинны. Конструкция `if … elif` выполняет только одну из взаимоисключающих ветвей. Кроме того, после первой замены строка меняется, поэтому следующая проверка может увидеть уже другой набор символов.
Алгоритм анализа исполнителя
При анализе алгоритма с заменами необходимо:
1. Переписать условие продолжения цикла без смысловых изменений.
2. Сохранить исходный порядок проверок.
3. Установить, сколько вхождений изменяет каждая команда.
4. Проверить вручную один полный проход.
5. Сопоставить промежуточную строку с результатом программы.
Если цикл не завершается, добавление произвольного ограничения числа итераций не исправляет ошибку алгоритма. Сначала необходимо проверить команды замены и условие продолжения. Ограничение количества шагов может использоваться при отладке для обнаружения зацикливания, но не заменяет корректную модель работы исполнителя.
Типичные ошибки: чтение файлов и перекрывающиеся вхождения
** изображение создано или обработано с помощью ИИ.
При чтении текстового файла может возникнуть ошибка из-за конечного символа перевода строки. Если его не удалить, длина данных окажется больше ожидаемой, а последний символ может нарушить условие задачи.
Для удаления символов перевода строки в конце строки можно использовать:
«`python
s = f.readline().rstrip(«rn»)
«`
Метод `rstrip(«rn»)` удаляет конечные символы r и n. В отличие от него, `strip()` удаляет пробельные символы с обоих концов строки, включая пробелы и табуляцию. Если пробелы входят в данные и влияют на решение, применять `strip()` без проверки условия нельзя.
Перекрывающиеся вхождения
Отдельная особенность связана с перекрывающимися вхождениями. В строке «AAAA» подстрока «AA» начинается с индексов 0, 1 и 2. Таким образом, существует три позиции начала. Однако выражение:
«`python
«AAAA».count(«AA»)
«`
вернёт 2, поскольку метод `count()` учитывает неперекрывающиеся вхождения.
Если требуется найти все позиции начала, необходимо проверять каждую допустимую позицию строки. Для шаблона длины m и строки длины n допустимы индексы от 0 до n — m включительно. В каждой позиции соответствующий срез сравнивается с шаблоном.
Вычислительная сложность полного перебора
Перебор всех подстрок также возможен, но перед его использованием следует оценить вычислительную сложность. Количество непустых непрерывных фрагментов строки длины n равно: n(n + 1) / 2.
Поэтому число проверок при полном переборе растёт квадратично. Для длинных строк один проход или скользящее окно часто эффективнее, если условие задачи допускает такой алгоритм.
При этом не существует универсального счётчика, подходящего для всех строковых задач. Выбор решения зависит от формулировки: необходимо учитывать допустимые символы, число ограниченных элементов, требование к соседним символам и возможность перекрытия вхождений.
Методика тренировки строковых задач
** изображение создано или обработано с помощью ИИ.
Для проверки алгоритма достаточно начать с коротких строк, результат обработки которых можно установить вручную. Тестовые примеры должны проверять граничные случаи, а не только обычную работу программы.
Полезно проверить:
— пустую строку, если она допустима по условию;
— строку из одного символа;
— случай, когда подходят все символы;
— случай, когда не подходит ни один символ;
— фрагмент максимальной длины в конце строки;
— несколько фрагментов с одинаковой максимальной длиной;
— строку с перекрывающимися вхождениями искомой подстроки.
После тестирования полезно сформулировать принцип работы алгоритма одним предложением. Например: «Алгоритм считает длину текущей серии и сохраняет максимальное значение». Если объяснение не отражает логику кода, необходимо вернуться к условию и уточнить правило обработки символов.
Ответы на частые вопросы
Необходимость запоминания всех строковых методов Python?
Для начала достаточно освоить индексацию, срезы, поиск, подсчёт и замену. Остальные методы можно изучать по мере появления задач, в которых они действительно нужны. Знание большого количества команд само по себе не гарантирует правильного решения.
Возможность решения без Python?
При использовании другого подходящего языка сохраняются основные принципы: последовательный обход строки, сравнение символов, поиск подстрок и хранение промежуточных результатов. Отличаться будут синтаксис и особенности встроенных функций.
Методика поиска ошибки в программе?
Полезно уменьшить входные данные и вывести промежуточные значения. В задаче на поиск фрагмента можно отслеживать индекс, текущую длину и максимум. В задаче с исполнителем — проверять строку после каждой замены. Такой пошаговый разбор позволяет определить момент, в котором фактическая работа программы расходится с условием.
Надёжное решение строковой задачи начинается с точного понимания условия, затем проверяется на небольшом примере и только после этого оформляется в код. Такой подход помогает избегать ошибок с индексами, заменами и границами фрагментов и делает решение более предсказуемым.
Системная подготовка к ЕГЭ по информатике помогает последовательно разобрать сложные темы, отработать типовые задачи и закрепить алгоритмы программирования. На курсах преподаватели помогают выстроить подготовку и довести навык решения строковых задач до автоматизма. Оценить методику и получить персональный план подготовки возможно на бесплатном пробном занятии. Записаться на курс можно на сайте el-ed.ru.
Хочешь начать готовиться, но остались вопросы?
Заполни форму, и мы подробно объясним, как устроена подготовка к ЕГЭ и ОГЭ в ЕГЭLAND